
2026年国产大模型已从"能用"迈向"好用"阶段。基于最新评测数据,对比六大主流模型的核心能力与适用场景。
🏆 性能对比:谁是真正的王者?
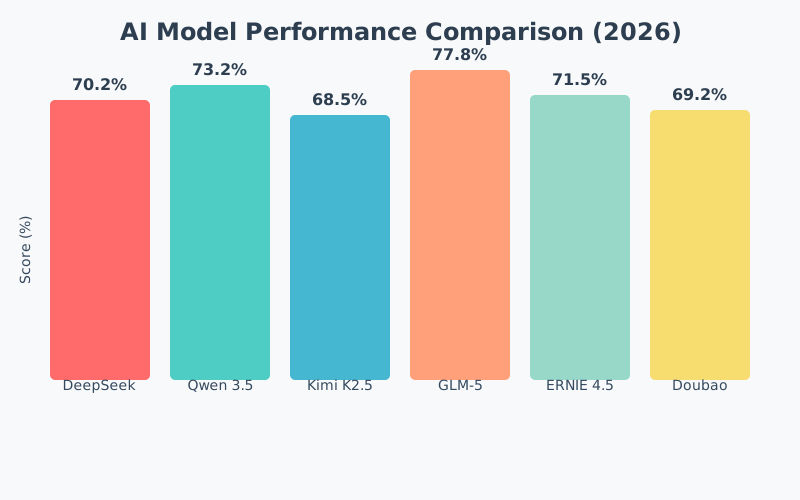
| 模型 | 厂商 | 核心优势 | 最佳场景 | 权威评分 |
|---|---|---|---|---|
| DeepSeek-V3.2 | 深度求索 | Agent能力登顶,推理超越GPT-5 | 编程、数学证明、工具调用 | Agent评测开源第一,多语言工程70.2%¹ |
| Qwen 3.5 | 阿里巴巴 | 性能对标GPT-5.2,价格仅1/18 | 通用对话、多模态、长文本 | LM Arena 1464分,全球第五² |
| Kimi K2.5 | 月之暗面 | 256K超长上下文,长文本王者 | 论文研读、合同分析、代码库理解 | 长文本理解准确率行业领先³ |
| GLM-5 | 智谱AI | 编程能力全球第一,极致性价比 | Agent编程、复杂系统工程 | Kilo CLI得分589,全球第一⁴ |
| 文心ERNIE 4.5 | 百度 | 多模态融合,中文理解强 | 中文问答、知识图谱、跨模态推理 | MMCU得分95.9,中文基准领先⁵ |
| 豆包Seed 2.0 Pro | 字节跳动 | 数学推理全球第一,多模态强 | 数学竞赛、视频生成、抖音生态 | SuperCLUE 69.16分,国内第一⁶ |
💰 成本横评:API Token价格对比(官方数据)
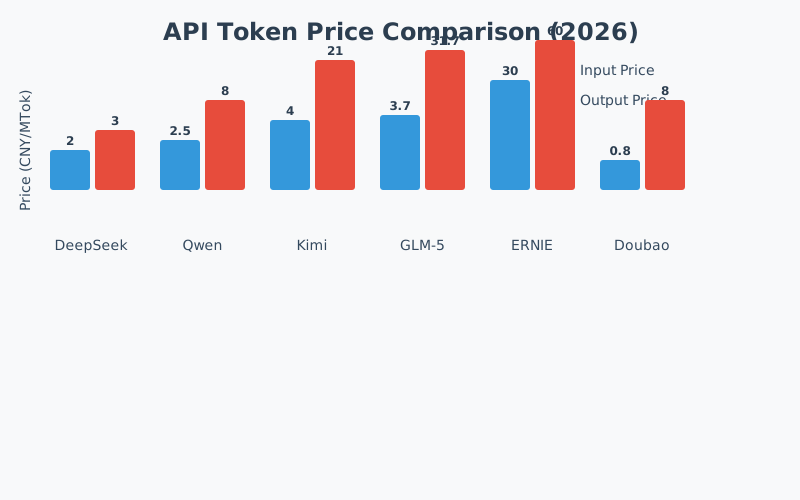
| 模型 | 输入价格 | 输出价格 | 缓存价格 | 性价比评级 | 适用人群 |
|---|---|---|---|---|---|
| DeepSeek-V3.2 | 2元/百万token | 3元/百万token | 0.2元/百万token | ⭐⭐⭐⭐⭐ | 开发者、科研人员 |
| Qwen 3.5 | 2.5元/百万token | 8元/百万token | 有缓存优惠 | ⭐⭐⭐⭐ | 创业团队、中小企业 |
| 豆包Seed 2.0 Pro | 0.8元/百万token | 8元/百万token | - | ⭐⭐⭐⭐⭐ | 个人用户、创作者 |
| Kimi K2.5 | 4元/百万token | 21元/百万token | 0.7元/百万token | ⭐⭐⭐ | 长文本需求用户 |
| GLM-5 | 3.7元/百万token | 31.7元/百万token | - | ⭐⭐⭐ | 编程开发者 |
| 文心ERNIE 4.5 | 30元/百万token | 60元/百万token | - | ⭐⭐ | 企业用户、中文场景 |
💡 成本亮点:
- DeepSeek:输入2元/百万token,缓存命中仅0.2元,极致性价比
- 豆包Pro:输入0.8元/百万token,输出8元,多模态能力强
- Qwen 3.5:输入2.5元/百万token,性能对标GPT-5.2,综合性价比高
- Kimi:缓存命中0.7元/百万token,长文本场景优势明显
⚠️ 价格说明:
- 价格单位:元/百万tokens(MTok)
- 数据来源:各模型官方API平台(2026年4月)
- 实际价格可能因套餐、用量、缓存策略有所不同
- 建议访问官网获取最新报价
🔥 关键发现
1. 性能梯队分化明显
第一梯队(对标GPT-5):DeepSeek-V3.2、Qwen 3.5、GLM-5
- DeepSeek在Agent工具调用评测中登顶开源榜首,多语言软件工程达70.2%
- Qwen 3.5在LM Arena拿到1464分,性能对标GPT-5.2但价格仅1/18
- GLM-5在Kilo CLI编程测试中以589分超越Claude Opus 4.6,位列全球第一
第二梯队(特定场景优势):Kimi K2.5、文心ERNIE 4.5、豆包Seed 2.0
- Kimi凭借256K上下文成为长文本处理王者
- 文心在中文基准MMCU上得分95.9,展现强大的中文理解能力
- 豆包数学推理87.83分全球第一,多模态能力突出
2. 成本竞争白热化
价格战已从"降价"升级为"重构成本":
- 极致低价:DeepSeek输入2元/百万token,缓存命中仅0.2元
- 性价比之王:豆包Pro输入0.8元/百万token,多模态能力强
- 综合优势:Qwen 3.5输入2.5元/百万token,性能对标GPT-5.2
3. 场景化选型成为关键
编程开发:GLM-5 > DeepSeek-V3.2 > Qwen 3.5
- GLM-5编程能力全球第一,成本最低
- DeepSeek Agent能力突出,适合工具调用场景
- Qwen综合能力强,适合通用开发
长文本处理:Kimi K2.5 > Qwen 3.5 > DeepSeek-V3.2
- Kimi 256K上下文,一次性处理40万字
- Qwen支持百万token,性价比高
- DeepSeek长文本效率优秀
数学推理:豆包Seed 2.0 > DeepSeek-V3.2 > GLM-5
- 豆包数学推理87.83分全球第一
- DeepSeek在IMO/ICPC级竞赛表现突出
- GLM-5数学能力稳步提升
中文任务:文心ERNIE 4.5 > Qwen 3.5 > Kimi K2.5
- 文心中文基准领先,知识图谱融合强
- Qwen中文友好,综合能力强
- Kimi长文本中文理解优秀
🎯 选型建议
预算充足,追求极致性能:
- 编程:GLM-5(全球第一,成本最低)
- Agent:DeepSeek-V3.2(工具调用登顶)
- 通用:Qwen 3.5(对标GPT-5.2)
成本敏感,追求性价比:
- 首选DeepSeek-V3.2(输入2元,缓存0.2元)
- 多模态:豆包Seed 2.0 Pro(输入0.8元,多模态强)
特定场景:
- 长文本:Kimi K2.5(256K上下文)
- 中文问答:文心ERNIE 4.5(中文理解强)
- 数学竞赛:豆包Seed 2.0(数学推理第一)
📚 引用来源
¹ DeepSeek-V3.2在Agent工具调用评测中登顶开源模型榜首,多语言软件工程评测达70.2%。来源:智源社区《DeepSeek-V3.2系列开源,性能直接对标Gemini-3.0-Pro》(2025-12-03) http://www.baidu.com/link?url=ZRH13HAQGjb6blK1Jukuq6s7RYEOa27bYU7NtISCL4ePHBm_h0WHWpuBaFHuSGi5
² Qwen3.5-Max-Preview在LM Arena拿到1464分,跃升至全球第五、中国第一。来源:数码圈大明白《阿里Qwen3.5登顶!国内大模型首进全球前五》(2026-03-20) http://www.baidu.com/link?url=Wv0zxPksLMCQfs1YEkT4ssdhx-Jxom0H-xuVR0at_eT52USFCtrOxyqya0XfpB5-1MOIF8zVjXnyhg5BK5DH1uMhxzyUlNcGtnhFKhPm6US
³ Kimi K2.5支持256K超长上下文,可一次性处理约40万字内容,长文本理解准确率行业领先。来源:CSDN博客《Kimi K2全新发布:256K上下文+超强编码能力详解》(2026-01-16) http://www.baidu.com/link?url=hRg3NEBF-9yU08pPOtDvGdYcmBwA0EUg4mXNsu8ybL6lJof-sH0v7VSdBv_C_cc1PrTYuGyCv-1ftKx6-Kw6vLh9MvIh6Mr4PMi3E5h6u4q
⁴ GLM-5在Kilo CLI测试中得分589,超越Claude Opus 4.6位列全球第一,编程成本仅0.14美元。来源:知乎《智谱GLM-5 实测》(2026-02-13) http://www.baidu.com/link?url=Ds8JBhI0EsQy89EyEWMSqDeqD-VrJgZOLab-42wRIaqLkHSozI3YFCbXIGkZue7fuvPUPwGcCQPxbXHLyj1Kza
⁵ 文心ERNIE-4.5在MMCU上达到95.9分,显著高于其他模型,中文基准领先。来源:CSDN博客《百度文心一言开源ERNIE-4.5深度测评报告:技术架构解读与性能对比》(2025-07-09) http://www.baidu.com/link?url=GpltWSLcfZxtPA4KJFu7I9BA8UmNC5XV3FaQi10e3fa-1UmYuoChrqzC-u7vlW2xG7mxi16772uvA0TYrTzcKBQ63ZEFNJQFXO5IBAypGwi
⁶ 豆包Seed 2.0 Pro在SuperCLUE 2025测评中总分69.16分,国内第一、全球第二,数学推理87.83分全球第一。来源:知乎《豆包大模型 2.0 中文通用测评结果发布 | 绝对领先、实力强悍!》(2026-03-01) http://www.baidu.com/link?url=ZKzxryKvOScGvNvKp0-ZVC6pHZshaojuaZnZdHP_YBkWrcpV7aTYRAYJFsScTY3nbeGlU4IS2KRC-F5EzAhbJK
数据更新:2026年4月 | 评测基准:LM Arena、SuperCLUE、Kilo CLI、MMCU等权威基准 | 价格来源:各模型官方API平台